Underdog показала голосовую модель Woof на 31 млн параметров: 32 МБ и работа без сети
Стартап выпустил браузерную игру, все голоса в которой синтезирует его новая модель синтеза речи. Woof занимает 31,7 МБ, открыта для скачивания и, по словам разработчиков, запускается на обычных устройствах без подключения к интернету.
Что случилось
Стартап Underdog 5 ноября выпустил браузерную игру, все голоса в которой синтезирует его новая модель Woof. Размер файла — 31,7 МБ, параметров — 31 млн. Модель открыта для скачивания и, по словам разработчиков, работает на большинстве устройств без подключения к интернету.
Детали
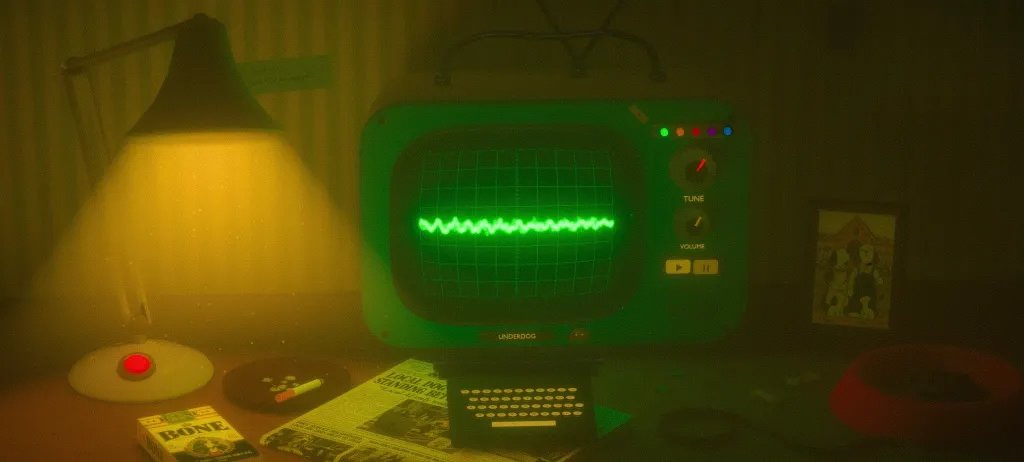
Игра построена вокруг комнаты в ретро-стиле: печатная машинка, ЭЛТ-монитор, настольная лампа со щёлкающим выключателем и радиотюнер. На машинке можно набрать любой текст, и игра озвучит его голосом Woof; вращая тюнер, пользователь получает разные музыкальные фрагменты.
Игра работает прямо в браузере, отдельная установка не требуется. Авторы называют Woof «фронтирной» моделью синтеза речи — то есть такой, которая по качеству должна конкурировать с крупными сервисами, но при этом помещается в обычную веб-страницу.
- вся генерация речи идёт в браузере, без обращения к облаку;
- 31,7 МБ — размер файла модели, 31 млн параметров;
- модель доступна для скачивания всем желающим;
- по замыслу авторов, она должна запускаться на обычных телефонах и ноутбуках;
- вступление к игре предупреждает о «навязчивых облачных провайдерах» — прямой выпад в сторону сервисов, которые считают речь на своих серверах.
Демонстрация идёт вразрез с общей гонкой: крупные лаборатории наращивают размеры моделей и требуют всё больше ускорителей, а часть исследователей и стартапов делает ставку на компактные модели для конечных устройств — телефонов, ноутбуков, встраиваемой техники. Для синтеза речи 31 млн параметров мало по меркам облачных сервисов, поэтому качество упирается в архитектуру и подготовку данных, а не в масштаб. Независимых замеров качества и задержек Underdog пока не публиковала, так что судить о модели приходится по демо.
Что это значит
Если такой синтез речи действительно работает на телефоне без сети, меняется не только цена. Голосовой интерфейс можно встраивать в приложения, которые не могут или не хотят отправлять аудио на чужой сервер, — от офлайн-переводчиков до медицинских и промышленных устройств. Для разработчиков это ещё и вопрос архитектуры: модель на десятки мегабайт влезает в мобильное приложение и не требует ни API-ключа, ни счёта за токены.
Ограничения тоже понятны. Облачные сервисы синтеза речи зарабатывают на объёме символов и добавляют задержку на передачу данных, зато держат качество на десятках языков и умеют управлять интонацией; компактные модели обычно уступают в словаре, эмоциях и редких языках, а на слабом процессоре им ещё нужно уложиться в реальное время. Проверять это придётся самостоятельно — вместе с лицензией, от которой зависит, можно ли ставить модель в коммерческий продукт.
Комментарии 0
Комментариев пока нет — будьте первым.
Оставить комментарий
Имя и текст — этого достаточно. Комментарий появится сразу; подозрительные сообщения уходят на проверку.